Concilier IA et RGPD revient à répondre à trois questions avant de brancher un modèle sur vos données : où sont-elles hébergées, qui les traite pour votre compte, et pouvez-vous prouver ce que l’IA en a fait ? Le RGPD ne contient aucun chapitre réservé à l’intelligence artificielle. Il s’applique tel quel dès qu’un agent, un assistant ou une automatisation manipule des données personnelles : un nom dans un email, une fiche client, un bulletin de paie. Cet article passe en revue les trois sujets qui décident de la conformité d’un projet : l’hébergement, la sous-traitance et la traçabilité. Pour chacun, vous trouverez ce que disent les textes et la CNIL, et ce que nous mettons en place dans nos projets.
IA et RGPD : quelles règles s’appliquent à une entreprise qui utilise l’IA ?
Les mêmes que pour n’importe quel traitement de données personnelles. Il faut une finalité précise, une base légale, des données limitées au nécessaire, une durée de conservation, une information des personnes et des mesures de sécurité. L’IA ne crée pas un régime à part. Elle rend simplement trois points plus délicats : les données circulent entre davantage d’acteurs, une partie du traitement se fait chez un fournisseur de modèle, et le résultat est moins prévisible qu’avec un logiciel classique.
La CNIL a publié plusieurs textes utiles pour s’y retrouver :
- des questions-réponses sur l’utilisation d’un système d’IA générative (juillet 2024), destinées aux organisations qui déploient ces outils ;
- des recommandations sur le développement des systèmes d’IA, finalisées le 22 juillet 2025 et accompagnées d’une liste de points à vérifier ;
- une note exploratoire sur l’IA agentique, publiée avec le Conseil de l’IA et du numérique le 20 juillet 2026. Elle constate que les agents font circuler les données entre de nombreux services et que le partage des responsabilités entre acteurs devient plus difficile à établir.
Le RGPD n’est plus le seul cadre. Le règlement européen sur l’IA ajoute des obligations qui dépendent du niveau de risque du système et de votre rôle. C’est un sujet à part entière, que nous traitons dans notre article AI Act et PME.
Où sont hébergées les données traitées par une IA ?
C’est la première question à poser, et la réponse tient rarement en un seul mot. Dans un projet d’agent IA, vos données passent par trois lieux distincts.
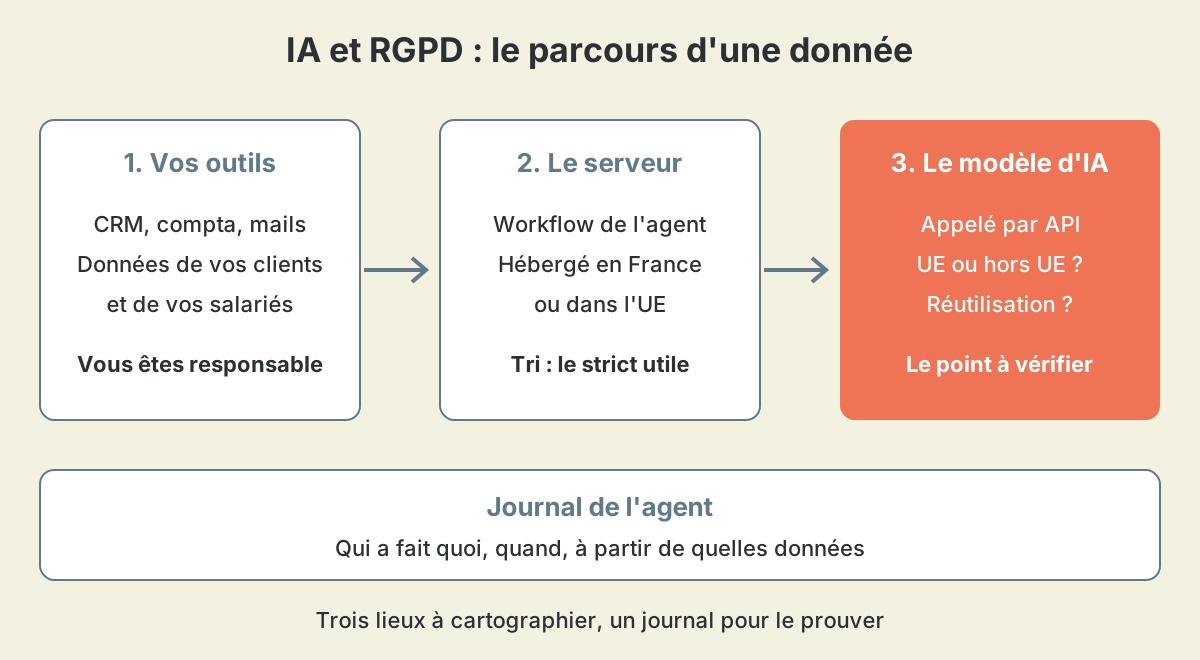 Les trois lieux par lesquels passe une donnée dans un projet d’agent IA. Le troisième, l’appel au modèle, est celui qui demande le plus de vérifications.
- Vos outils : CRM, logiciel comptable, messagerie, stockage de documents. Les données y sont déjà, sous votre responsabilité.
- Le serveur qui exécute l’agent : c’est lui qui lit vos outils, prépare la requête et écrit le résultat. Il voit passer tout ce que l’agent consulte.
- Le modèle d’IA : il reçoit le texte de la requête et renvoie une réponse. S’il est appelé par API, ce texte quitte votre serveur pour celui du fournisseur.
Dans ses questions-réponses, la CNIL distingue trois modes de déploiement : sur site, sur une infrastructure cloud, ou par API. Pour des données personnelles ou une documentation sensible, elle juge qu’il est en général plus sûr de privilégier une solution installée sur site. Avec une API, elle relève que la maîtrise du système reste presque entièrement entre les mains du fournisseur.
| Mode de déploiement | Où sont les données | Ce que vous maîtrisez | Adapté à |
|---|---|---|---|
| Service grand public (interface web) | Chez l’éditeur, selon ses conditions générales | Presque rien, hormis les réglages du compte | Contenus sans donnée personnelle ni information confidentielle |
| Modèle appelé par API depuis votre serveur | Vos données restent chez vous, seul le texte de la requête part chez le fournisseur | Ce qui est envoyé, le contrat, la durée de conservation négociée | La plupart des agents métier, avec tri des données en amont |
| Modèle ouvert hébergé sur votre serveur | Entièrement sur votre infrastructure | Tout, y compris la sécurité à assurer vous-même | Données sensibles ou clients qui refusent tout envoi à un tiers |
Chez GetBatch, nos infrastructures sont hébergées dans l’Union européenne. Quand l’orchestration repose sur n8n, l’instance est auto-hébergée sur un serveur en France, qu’elle soit suivie par notre agence n8n à Toulouse ou par notre agence n8n à Paris. Le choix entre la version cloud de n8n et une instance auto-hébergée se résume ainsi : en auto-hébergé, les données de vos workflows restent sur un serveur à votre nom. Le détail de cette installation est sur la page de notre agence n8n.
L’hébergement en France suffit-il à garantir la souveraineté des données IA ?
Non, et c’est le malentendu le plus fréquent. La souveraineté des données IA se joue à trois niveaux, que l’on confond souvent.
- La localisation : dans quel pays se trouvent les serveurs. C’est le niveau le plus simple à vérifier, et le RGPD n’impose pas la France : les données circulent librement dans l’Union européenne.
- Le droit applicable : à quelles lois obéit l’entreprise qui exploite ces serveurs. Un centre de données situé en Europe peut appartenir à un groupe soumis à une législation étrangère, qui permet à ses autorités de demander l’accès à certaines données.
- La maîtrise : qui détient les accès, qui peut exporter les données, et ce qui se passe si vous changez de prestataire. Ce dernier point rejoint la réversibilité d’un agent IA.
La CNIL adopte sur ce sujet une position graduée. Pour les traitements les plus sensibles (elle cite les grandes bases de données de santé, les données relatives aux infractions ou aux mineurs), elle recommande de recourir à un prestataire exclusivement soumis au droit européen. En France, la qualification SecNumCloud de l’ANSSI comporte des critères de protection contre les lois extra-européennes. Pour les données courantes d’une PME, ce niveau d’exigence n’est pas une obligation. C’est un arbitrage à faire en connaissance de cause, selon la sensibilité des données et les attentes de vos propres clients.
Pour une entreprise qui manipule des données clients, comptables ou contractuelles, l’essentiel est de rester dans un cadre juridique qu’elle maîtrise, et de savoir répondre précisément à ces trois questions plutôt que d’afficher un simple « hébergé en France ».
Peut-on envoyer des données personnelles à un modèle d’IA hébergé hors de l’Union européenne ?
Oui, à condition que le transfert entre dans l’un des cas prévus par le chapitre V du RGPD. La CNIL en rappelle quatre.
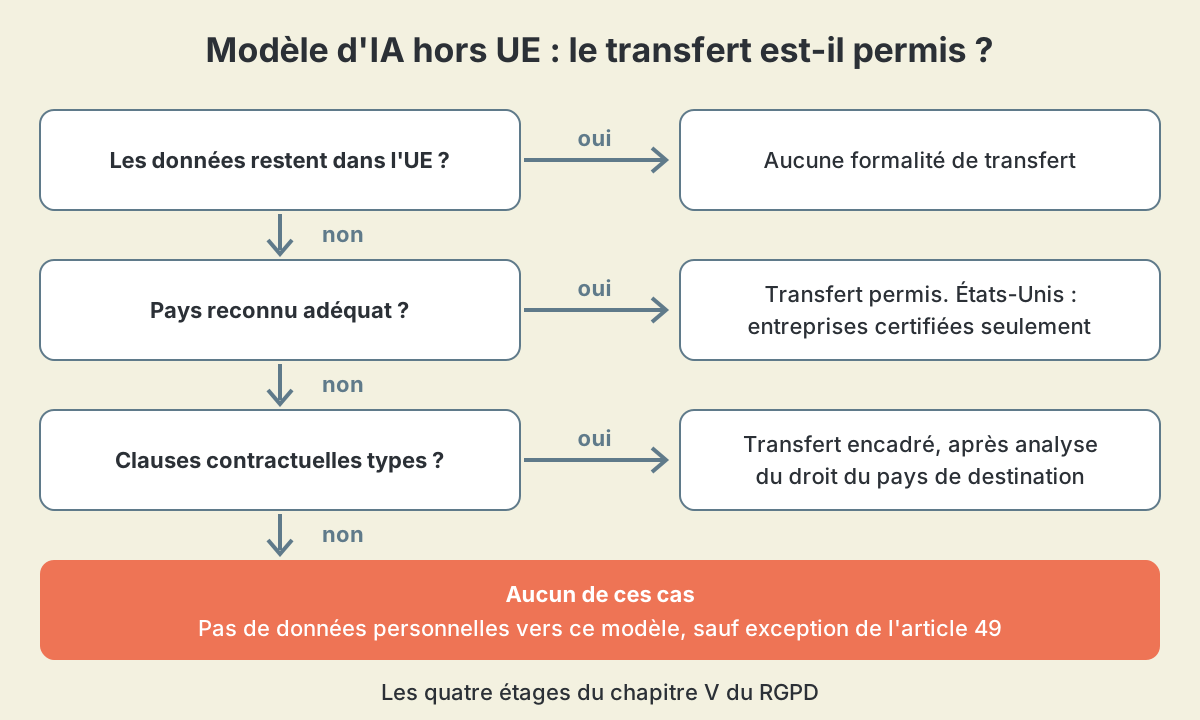 Les quatre étages à parcourir avant d’envoyer des données personnelles à un modèle d’IA hébergé hors de l’Union européenne.
- La décision d’adéquation : la Commission européenne reconnaît qu’un pays offre un niveau de protection suffisant. Le transfert se fait alors sans outil supplémentaire.
- Les clauses contractuelles types : des modèles de contrat adoptés par la Commission, que signent l’exportateur et le destinataire. Elles supposent d’avoir évalué la législation du pays de destination.
- Les règles d’entreprise contraignantes : un code interne à un groupe, validé par les autorités de protection des données.
- Les dérogations de l’article 49 : réservées, selon la CNIL, à des situations particulières. On ne bâtit pas un flux quotidien dessus.
Le cas des États-Unis mérite une précision, puisque plusieurs grands fournisseurs de modèles y sont établis. Une décision d’adéquation a été adoptée le 10 juillet 2023. Elle ne couvre que les entreprises américaines certifiées au titre du cadre de protection des données entre l’Union européenne et les États-Unis : pour un destinataire non certifié, il faut revenir aux clauses contractuelles types. Le Tribunal de l’Union européenne a rejeté en septembre 2025 un recours en annulation de cette décision. Le cadre reste discuté, et les deux accords précédents ont été invalidés par la justice européenne. Mieux vaut donc ne pas faire dépendre tout un projet de ce seul fondement.
En pratique, trois précautions réduisent fortement l’enjeu :
- Envoyer moins : l’agent ne transmet au modèle que le contenu utile à la requête, jamais l’historique complet d’un client.
- Retirer ce qui identifie : quand la tâche le permet, remplacer les noms et les coordonnées par des repères neutres avant l’appel, puis les rétablir dans la réponse.
- Garder une solution européenne possible : si vous préférez que rien ne quitte l’Europe, l’agent peut être conçu avec un modèle européen comme Mistral, ou avec un modèle ouvert hébergé sur votre serveur.
Chez nous, lorsqu’un modèle tiers est mobilisé, nous sélectionnons en priorité des fournisseurs conformes au cadre européen, et les transferts éventuels hors UE sont encadrés par les clauses contractuelles types de la Commission européenne.
Les données envoyées à une IA servent-elles à entraîner le modèle ?
Cela dépend du fournisseur, de l’offre souscrite et des réglages. C’est un point de vigilance concret : certains services réutilisent par défaut les données qui leur sont confiées pour améliorer leurs modèles. La CNIL recommande, pour un service grand public, de désactiver cette possibilité de réutilisation, et de ne pas y saisir d’informations confidentielles ou de données personnelles.
Avant de retenir un fournisseur, quatre lignes de ses conditions sont à lire :
- les données envoyées sont-elles réutilisées pour l’entraînement, et peut-on s’y opposer par contrat ?
- combien de temps les requêtes et les réponses sont-elles conservées ?
- dans quels pays sont-elles traitées ?
- à quels autres prestataires le fournisseur fait-il lui-même appel ?
Notre engagement sur ce point est simple à formuler. Vos données restent votre propriété exclusive. Elles ne sont utilisées que pour faire fonctionner votre agent, dans le périmètre contractualisé, et ne sont jamais versées dans l’entraînement de modèles publics. Nous sélectionnons nos fournisseurs précisément sur ce critère : pas de réutilisation pour l’entraînement, et suppression après une durée de conservation limitée. Ce critère pèse autant que la performance dans le choix du modèle d’IA.
Qui est responsable de traitement et qui est sous-traitant dans un projet d’IA ?
Le RGPD distingue celui qui décide du traitement (le responsable) de celui qui l’exécute pour son compte (le sous-traitant). Dans un projet d’agent IA sur mesure, la répartition habituelle est la suivante.
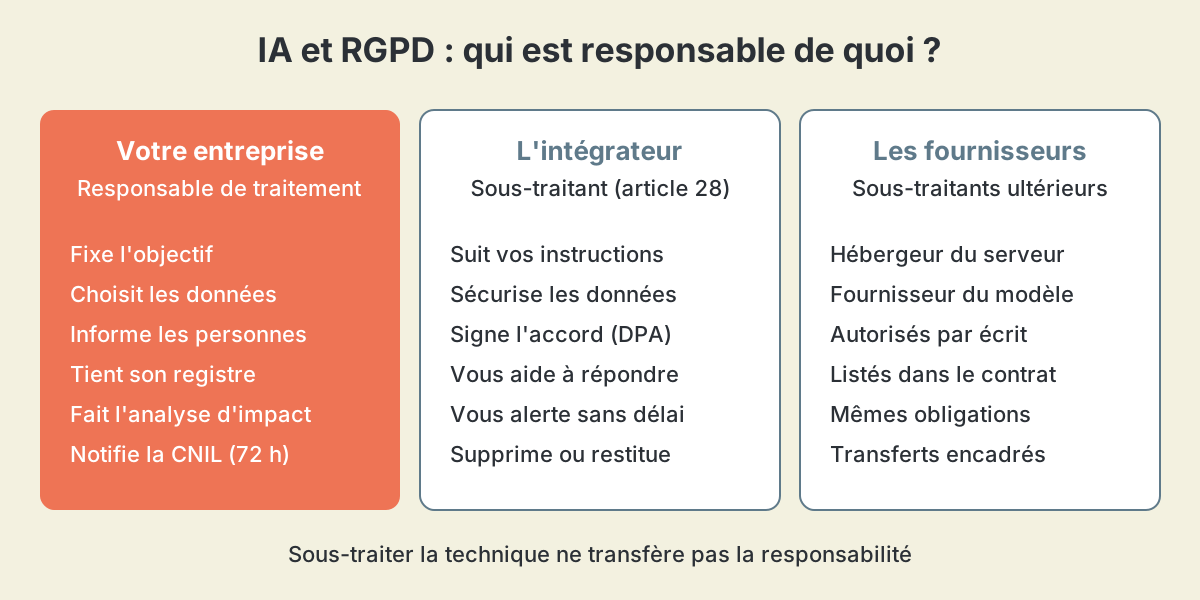 Qui porte quelle obligation dans un projet d’agent IA. Confier la technique à un prestataire ne transfère pas la responsabilité du traitement.
Vous restez responsable de traitement : vous fixez l’objectif de l’agent et vous décidez des données qu’il consulte. Nous agissons en tant que sous-traitant au sens de l’article 28. L’hébergeur du serveur et le fournisseur du modèle sont des sous-traitants ultérieurs : ils ne peuvent être recrutés qu’avec votre autorisation écrite, et les mêmes obligations de protection leur sont imposées par contrat.
Cette répartition n’est pas automatique. La CNIL précise qu’un fournisseur qui développe un système d’IA pour un client est sous-traitant si le client détermine l’objectif et les moyens. Si le client se contente de donner un objectif et laisse le fournisseur concevoir seul le système, ce dernier peut devenir responsable de traitement. Elle indique aussi qu’une organisation qui relie un modèle à sa propre base documentaire est responsable de ce traitement lorsque la base contient des données personnelles. D’où l’intérêt d’écrire les rôles noir sur blanc.
Que doit contenir l’accord de traitement des données (DPA) ?
L’article 28 du RGPD impose un contrat écrit entre le responsable et son sous-traitant. Il doit prévoir que le sous-traitant :
- ne traite les données que sur instruction documentée du responsable ;
- s’assure que les personnes qui y accèdent sont tenues à la confidentialité ;
- met en place les mesures de sécurité requises ;
- ne fait appel à un autre sous-traitant qu’avec une autorisation écrite ;
- aide le responsable à répondre aux demandes des personnes (accès, rectification, effacement) ;
- l’aide à remplir ses obligations de sécurité, de notification des violations et d’analyse d’impact ;
- supprime ou restitue les données à la fin de la prestation, au choix du responsable ;
- met à disposition les informations qui prouvent le respect de ces engagements et permet les audits.
Pour un projet d’IA, nous conseillons d’y faire figurer en plus la liste nominative des fournisseurs de modèles et d’hébergement, les pays de traitement et l’interdiction de réutiliser les données pour l’entraînement. La question de l’hébergement et des services tiers fait partie des questions à poser à un intégrateur n8n avant de signer.
Registre des traitements, analyse d’impact : quels documents préparer ?
Trois obligations documentaires reviennent dans presque tous les projets.
Le registre des traitements. L’agent IA doit y figurer comme un traitement, avec sa finalité, les catégories de données, les destinataires, les transferts hors UE et les durées de conservation. Les entreprises de moins de 250 salariés bénéficient d’une dérogation, mais la CNIL souligne qu’elle est limitée à des cas très particuliers : tout traitement non occasionnel doit être inscrit. Un agent qui tourne chaque jour n’a rien d’occasionnel. Le sous-traitant tient de son côté un registre de ses activités de sous-traitance.
L’analyse d’impact (AIPD). Elle est obligatoire quand le traitement est susceptible d’engendrer un risque élevé pour les personnes. La CNIL retient neuf critères, et considère qu’une analyse est en principe requise lorsque deux d’entre eux sont remplis. Parmi ces critères : l’évaluation ou la notation de personnes, la décision automatisée avec effet juridique, les données sensibles, le croisement de données, les personnes vulnérables et l’usage innovant d’une nouvelle technologie. Un agent IA coche facilement ce dernier critère. Il suffit alors d’un second, par exemple un agent qui note des candidatures ou qui croise plusieurs fichiers clients, pour que l’analyse s’impose.
La notification des violations. En cas de fuite ou d’accès non autorisé, le responsable de traitement prévient la CNIL dans les meilleurs délais et, si possible, 72 heures au plus tard après en avoir pris connaissance, sauf si la violation ne présente pas de risque pour les personnes. Le sous-traitant doit de son côté alerter le responsable dès qu’il en a connaissance. Il faut donc savoir qui appeler, et avoir des journaux qui permettent de mesurer ce qui a été touché.
Les sanctions prévues par le RGPD donnent la mesure de l’enjeu : jusqu’à 10 millions d’euros ou 2 % du chiffre d’affaires annuel mondial pour un manquement aux obligations du responsable et du sous-traitant, jusqu’à 20 millions d’euros ou 4 % pour une violation des règles sur les transferts hors UE.
Dans nos projets, cela se traduit par un accord de traitement des données, un registre des traitements et, lorsque c’est pertinent, une analyse d’impact. Ce cadre est contractualisé dès le premier jour, comme le prévoit notre méthode de projet d’agent IA.
Comment assurer la traçabilité d’un agent IA ?
La traçabilité répond à une question simple : qu’a fait l’agent, quand, et à partir de quelles données ? Sans réponse, impossible de traiter une demande d’accès, d’expliquer une erreur ou de mesurer l’étendue d’un incident. Nos agents journalisent chaque action, et ce journal est auditable.
Un journal utile contient, pour chaque exécution :
| Élément journalisé | À quoi il sert |
|---|---|
| Date, heure et déclencheur (email reçu, formulaire, planification) | Reconstituer la chronologie |
| Sources consultées (quelle fiche, quel document) | Savoir quelles données ont été lues |
| Fournisseur et modèle appelés | Identifier un éventuel transfert hors UE |
| Action réalisée (brouillon créé, fiche modifiée, message envoyé) | Mesurer les conséquences |
| Validation humaine, avec le nom du valideur | Établir qui a décidé |
| Erreur ou refus | Détecter les dérives |
Deux pièges sont à éviter. Le premier est de recopier dans le journal l’intégralité des données traitées : le journal devient alors un second fichier client, moins bien protégé que le premier. On y inscrit des identifiants et des références, pas le contenu des dossiers. Le second est de tout conserver indéfiniment. La CNIL recommande, pour les journaux de traçabilité, une durée de conservation comprise entre six mois et un an, sauf besoin particulier à justifier.
La traçabilité est aussi ce qui rend un agent supervisable : on ne contrôle bien que ce qu’on peut relire. Les niveaux de contrôle et les garde-fous sont détaillés dans notre article sur la supervision humaine d’un agent IA.
Exemple type : un agent IA qui trie les demandes clients d’une PME de services
Prenons un cas fictif, représentatif des projets courants. Une société de services de trente personnes reçoit chaque jour des dizaines de demandes par email. Elle veut un agent qui les classe, retrouve le dossier du client et prépare un brouillon de réponse, relu par un conseiller avant envoi.
Étape 1 : cartographier les données. L’agent lit les emails entrants (nom, adresse, contenu libre) et consulte le CRM (historique, contrat). Aucune donnée de santé ni donnée bancaire n’est attendue, mais un client peut en écrire spontanément dans son message. Ce cas est prévu : l’agent signale le message au lieu de le traiter.
Étape 2 : limiter ce qui part au modèle. Le workflow tourne sur un serveur en France. Il n’envoie au modèle que le texte de la demande et les trois champs du CRM utiles à la réponse. L’historique complet reste sur place.
Étape 3 : choisir le fournisseur du modèle. Deux options sont comparées : un fournisseur américain certifié, avec engagement contractuel de non-réutilisation, et un fournisseur européen. La société travaille pour des collectivités dont les cahiers des charges exigent un traitement dans l’Union : elle retient l’option européenne.
Étape 4 : écrire les rôles. La société est responsable de traitement. L’intégrateur est sous-traitant, l’hébergeur et le fournisseur du modèle sont listés comme sous-traitants ultérieurs dans l’accord de traitement.
Étape 5 : compléter les documents. Le traitement est ajouté au registre. Les critères de l’analyse d’impact sont passés en revue : usage innovant, mais ni notation de personnes, ni données sensibles, ni décision automatisée, puisqu’un conseiller valide chaque réponse. La conclusion et son raisonnement sont consignés par écrit.
Étape 6 : régler la journalisation. Chaque exécution enregistre l’identifiant de l’email, la fiche consultée, le modèle appelé et le nom du conseiller qui a validé. Le contenu des messages n’est pas recopié dans le journal.
Résultat : le jour où un client demande ce que l’entreprise a fait de ses données, ou qu’un acheteur public envoie son questionnaire de sécurité, la réponse tient en une page, et elle est déjà écrite.
Checklist IA et RGPD : 10 points à vérifier avant de lancer un projet
- La finalité de l’agent est écrite en une phrase, et sa base légale est identifiée.
- Les données personnelles qu’il lit et qu’il écrit sont listées, outil par outil.
- Le lieu d’hébergement du serveur est connu, ainsi que l’entreprise qui l’exploite.
- Le fournisseur du modèle, ses pays de traitement et sa durée de conservation sont connus.
- La non-réutilisation des données pour l’entraînement est garantie par contrat.
- Tout transfert hors UE repose sur un fondement identifié (adéquation ou clauses contractuelles types).
- Un accord de traitement conforme à l’article 28 est signé, avec la liste des sous-traitants ultérieurs.
- Le traitement figure au registre, et la question de l’analyse d’impact a été tranchée par écrit.
- Chaque action de l’agent est journalisée, avec une durée de conservation définie.
- Une procédure dit qui prévenir en cas d’incident, et comment restituer ou supprimer les données en fin de contrat.
La conformité est-elle un frein ou un atout commercial ?
On présente souvent le RGPD comme un obstacle à l’innovation. Nous le voyons plutôt comme un cadre qui force à faire les choses proprement. Savoir où sont les données, qui y accède, et pour combien de temps, ce ne sont pas des contraintes parasites : ce sont les bonnes questions à se poser de toute façon. Un agent qui respecte ces règles est, par construction, mieux conçu : plus auditable, plus maîtrisé, plus durable.
La conformité déteint aussi sur toute votre chaîne. Si vous traitez les données de vos clients avec un agent, ces clients sont en droit de savoir où finissent leurs informations. Pouvoir répondre clairement (hébergement en Europe, pas de réutilisation pour l’entraînement, traçabilité complète) devient un argument commercial autant qu’une protection juridique. C’est particulièrement vrai dans les secteurs réglementés ou sensibles : santé, finance, juridique, données RH. Un appel d’offres ou un audit client se passe beaucoup mieux quand la gouvernance des données de l’agent est documentée et défendable.
C’est cohérent avec notre approche du sur-mesure, que nous comparons aux logiciels du marché dans SaaS ou agent IA sur mesure : un agent sérieux n’est pas une boîte noire posée sur vos données, mais un système dont vous gardez le contrôle de bout en bout, de l’hébergement jusqu’au moindre accès.
Questions fréquentes
Peut-on utiliser ChatGPT en entreprise en respectant le RGPD ?
Cela dépend de la version utilisée et de ce qu’on y saisit. Pour un service grand public, la CNIL recommande de ne pas saisir de données personnelles ni d’informations confidentielles, de désactiver la réutilisation des données par le fournisseur et d’encadrer les usages par une charte interne. Pour un usage métier sur des données clients, il faut une offre professionnelle avec un accord de traitement, ou un modèle appelé depuis votre propre serveur.
Faut-il le consentement des clients pour qu’un agent IA traite leurs données ?
Pas nécessairement. Le consentement n’est que l’une des six bases légales prévues par le RGPD, aux côtés notamment de l’exécution d’un contrat et de l’intérêt légitime. Un agent qui prépare la réponse à une demande envoyée par le client lui-même ne repose pas, en général, sur le consentement. En revanche, les personnes doivent être informées du traitement, et la base retenue doit être inscrite au registre. Ce choix se valide avec votre délégué à la protection des données ou votre conseil.
Le RGPD oblige-t-il à héberger ses données en France ?
Non. Le RGPD n’impose ni la France ni même l’Union européenne : il encadre les transferts vers les pays tiers. L’hébergement en France ou dans l’UE reste le moyen le plus simple d’éviter ces formalités, et il répond à ce que demandent beaucoup de donneurs d’ordre. Certains secteurs ont en revanche leurs propres règles d’hébergement, à vérifier au cas par cas.
Combien de temps conserver les journaux d’un agent IA ?
La CNIL recommande de conserver les journaux de traçabilité entre six mois et un an. Une durée plus longue est possible si elle est justifiée et documentée, par exemple pour un besoin de contrôle interne ou une obligation légale. La durée retenue s’inscrit dans le registre des traitements, et la purge doit être automatique.
IA et RGPD : commencer par la carte des données
Un projet d’IA conforme ne commence pas par le choix du modèle, mais par une carte : quelles données, dans quels outils, envoyées à qui, conservées combien de temps. Une fois cette carte tracée, l’hébergement, le contrat de sous-traitance et la journalisation se décident sans difficulté, et la conformité cesse d’être une inquiétude pour devenir un dossier que vous pouvez montrer.
Ces garanties s’appliquent à chacun de nos projets, qu’il s’agisse d’un agent complet ou d’une automatisation menée par notre agence n8n. Les réponses courtes sur la sécurité et les données figurent aussi dans notre FAQ. Des exigences précises sur l’hébergement ou la conformité dans votre secteur ? Parlons-en, on vous explique exactement comment vos données seront traitées.