Choisir un modèle d’IA ne revient pas à prendre le plus gros, le plus récent ou le plus médiatisé : le bon modèle est celui qui réussit votre tâche, au coût le plus bas, sans faire sortir vos données du périmètre que vous acceptez. Ce choix se fait sur cinq critères et se vérifie par un test sur vos propres cas, pas sur un classement publié. La question « IA open source ou propriétaire » n’est qu’une partie de la réponse, et rien n’oblige à retenir un seul modèle pour tout un agent. Voici la grille que nous appliquons sur nos projets, avec un exemple type et une méthode de test que vous pouvez reprendre.
Quels critères pour choisir un modèle d’IA ?
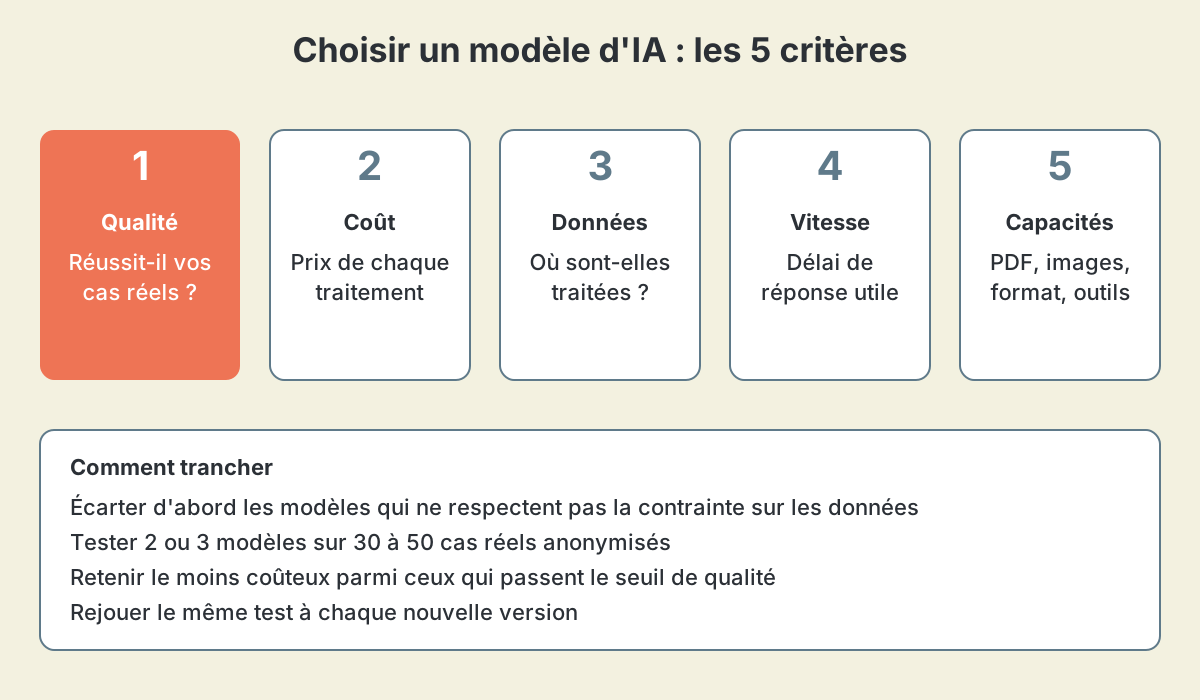 Les cinq critères que nous passons en revue avant de choisir un modèle d’IA. Le premier, la qualité sur vos cas réels, ne se lit dans aucun classement : il se mesure.
Pour chaque tâche confiée à un agent, nous arbitrons entre cinq critères. Aucun ne prime par principe : c’est le contexte qui décide.
- La qualité sur la tâche. Le modèle est-il assez bon pour ce travail précis ? Résumer une réunion et analyser finement un contrat n’exigent pas la même puissance. Surdimensionner, c’est payer une capacité qui ne sert pas.
- Le coût de chaque traitement. Un modèle se paie à l’usage, à chaque appel. Sur une tâche répétée des centaines de fois par jour, l’écart entre deux modèles finit par peser plus lourd que le projet lui-même.
- Les données. Où sont-elles traitées, par qui, et servent-elles à autre chose qu’à vous répondre ? Selon leur sensibilité, on retient un fournisseur qui traite en Europe, ou un modèle ouvert installé sur un serveur que vous maîtrisez.
- La vitesse. Un assistant qui répond à un client en direct doit réagir en quelques secondes. Un traitement de nuit peut prendre son temps, et profiter des tarifs réduits que des éditeurs comme Anthropic accordent aux traitements par lots.
- Les capacités techniques. Le modèle lit-il correctement un PDF scanné ou une photo ? Respecte-t-il un format de sortie imposé ? Sait-il appeler des outils ? Écrit-il un français naturel ? Peut-il avaler un document de cent pages d’un coup ?
Le tableau suivant résume la question à se poser pour chaque critère et la façon de la vérifier.
| Critère | La question à se poser | Comment le vérifier |
|---|---|---|
| Qualité | Le modèle réussit-il mes cas réels, y compris les cas tordus ? | Un jeu de test de 30 à 50 exemples tirés de votre activité |
| Coût | Combien coûte un traitement, multiplié par mon volume mensuel ? | La consommation mesurée pendant le test, pas la grille tarifaire seule |
| Données | Ces informations peuvent-elles sortir de mon périmètre ? | Les conditions du fournisseur : lieu de traitement, conservation, réutilisation |
| Vitesse | Quelqu’un attend-il la réponse ? | Le temps de réponse mesuré sur vos documents, à vos heures de pointe |
| Capacités | Ai-je besoin d’images, d’un format strict, d’outils, de longs documents ? | Un essai sur vos pièces les plus difficiles : scans, tableaux, écriture manuscrite |
Un conseil d’ordre : commencez par le critère des données. Il élimine des options avant même de parler de performance, et il évite de tomber amoureux d’un modèle que vous n’aurez pas le droit d’utiliser.
IA open source ou propriétaire : quelle différence concrète ?
Un modèle propriétaire reste chez son éditeur. Vous l’utilisez à distance, par son API, et vous payez à l’usage. C’est le cas des modèles Claude d’Anthropic, des modèles GPT d’OpenAI ou des modèles Gemini de Google. Vous profitez souvent des meilleures performances brutes et d’une mise en route immédiate, en échange d’une dépendance aux tarifs, aux conditions et au calendrier de l’éditeur.
Un modèle ouvert se télécharge : l’éditeur publie ses « poids », c’est-à-dire le fichier qui contient le modèle entraîné. Vous pouvez alors le faire tourner où vous voulez. Attention au vocabulaire : « open source » est souvent employé pour tout modèle téléchargeable, alors que les licences diffèrent beaucoup. Certains modèles sont publiés sous une licence libre comme Apache 2.0, qui autorise l’usage commercial sans condition particulière. D’autres ont des poids ouverts mais une licence propre à l’éditeur, qui peut encadrer certains usages. Mistral AI illustre bien les deux cas : d’après sa documentation, Mistral Small 4 et les modèles Ministral 3 sont sous Apache 2.0, tandis que Mistral Large 4 est publié sous une licence spécifique à Mistral, à lire avant de bâtir dessus.
La vraie décision n’est donc pas binaire. Elle se joue entre trois façons d’utiliser un modèle.
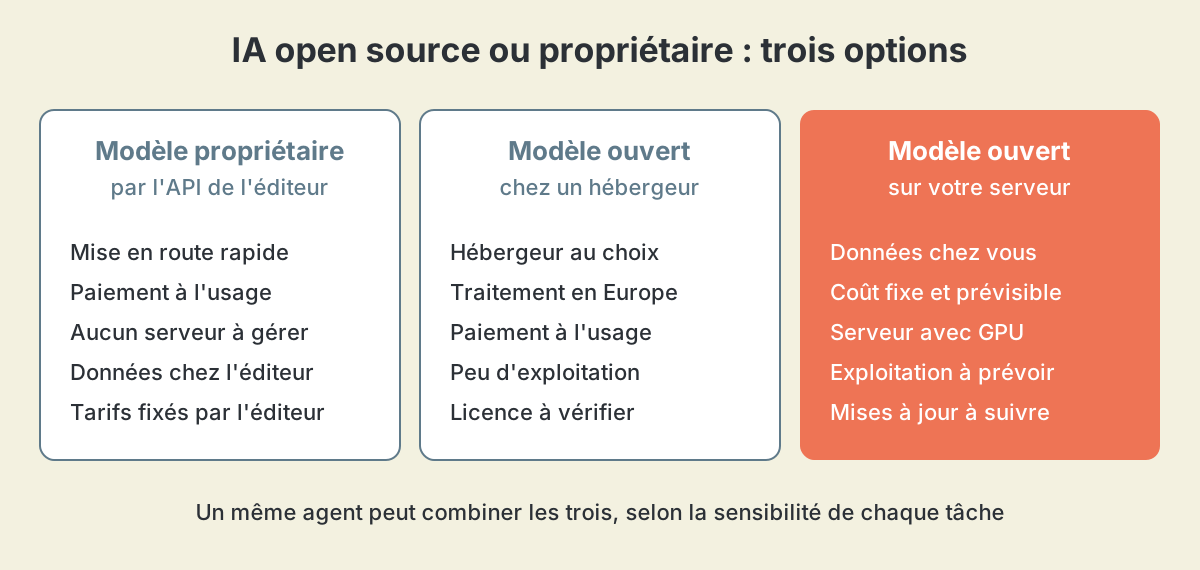 Entre l’API d’un éditeur et le serveur maison, il existe une voie intermédiaire souvent oubliée : un modèle ouvert servi par un hébergeur de votre choix.
| Modèle propriétaire par API | Modèle ouvert chez un hébergeur | Modèle ouvert auto-hébergé | |
|---|---|---|---|
| Mise en route | Immédiate | Rapide | Plusieurs jours à plusieurs semaines |
| Facturation | À l’usage | À l’usage | Coût fixe du serveur, quel que soit le volume |
| Où vont les données | Chez l’éditeur, selon ses conditions | Chez l’hébergeur choisi, possible en Europe | Nulle part : elles restent chez vous |
| Exploitation | Aucune | Faible | Serveur avec carte graphique, mises à jour, surveillance |
| Liberté de changer | Dépend de l’éditeur | Forte : le même modèle existe chez plusieurs hébergeurs | Totale |
| Performance de pointe | Souvent la meilleure | Bonne, écart variable selon la tâche | Limitée par la taille de votre serveur |
Notre position est sans dogme. Un modèle propriétaire par API est un excellent point de départ pour un premier agent, à condition d’encadrer le traitement des données. Un modèle ouvert prend l’avantage quand la confidentialité est critique ou quand le volume rend la facture à l’usage difficile à prévoir. Nous documentons le choix pour que vous puissiez le comprendre et, plus tard, le remettre en question.
Quels sont les principaux modèles d’IA fin 2026 ?
Les noms changent tous les trimestres, mais la logique des gammes reste la même : chaque éditeur propose un modèle léger pour le volume, un modèle équilibré et un ou deux modèles de pointe. Voici l’état des gammes publiques que nous avons relevé sur les pages officielles le 12 novembre 2026.
| Éditeur | Modèles de la gamme actuelle | Type |
|---|---|---|
| Anthropic | Claude Haiku 5.5 (le plus léger), Claude Sonnet 5.5, Claude Opus 5.5, Claude Fable 5.2 (le plus puissant) | Propriétaire, par API |
| OpenAI | GPT-6 Luna (présenté comme le plus économe, pour le volume), GPT-6.1 Terra, GPT-6.1 Sol, GPT-6 Astra | Propriétaire, par API |
| Gemini 3.5 Flash-Lite, Gemini 3.6 Flash, Gemini 3.8 Flash, Gemini 4 Carbon, Gemini 4 Argon ; la famille Gemma 4 est téléchargeable | Propriétaire par API, sauf Gemma | |
| Mistral AI | Ministral 3 (les plus légers), Mistral Small 4, Mistral Large 4 | Éditeur français, API et poids ouverts |
Sources : les pages de modèles d’Anthropic, d’OpenAI, de Google et de Mistral AI.
Deux lectures utiles de ce tableau. D’abord, les éditeurs eux-mêmes ne recommandent pas leur modèle le plus puissant pour tout : Anthropic présente Claude Haiku 5.5 comme le modèle des tâches à fort volume (classification, extraction, routage) et réserve Claude Fable 5.2 aux raisonnements les plus exigeants. Ensuite, ce tableau sera périmé dans quelques mois. C’est une raison de plus pour choisir une méthode plutôt qu’un nom, et pour vérifier les pages officielles le jour où vous décidez.
Faut-il toujours prendre le modèle le plus puissant ?
Non, et c’est souvent contre-productif. Les écarts de prix à l’intérieur d’une même gamme sont considérables. Sur la grille publique d’Anthropic au 12 novembre 2026, Claude Haiku 5.5 démarre à 0,10 $ par million de tokens en entrée, contre 8 $ pour Claude Fable 5.2 : un rapport de 1 à 80 pour le texte envoyé au modèle. Confier un simple tri de messages au modèle de pointe, c’est payer ce rapport sans rien obtenir de plus.
Le modèle le plus puissant est aussi, en général, le plus lent. Et il ne règle pas les vrais problèmes d’un agent : une consigne floue, des données d’entrée de mauvaise qualité ou une règle métier jamais écrite produisent de mauvais résultats avec n’importe quel modèle.
La bonne règle est inverse : partir du modèle le plus léger qui pourrait convenir, et ne monter en gamme que si le test montre qu’il échoue. Le détail du budget d’API et de son poids dans un projet est traité dans notre article sur le prix d’un agent IA sur mesure.
Comment tester un modèle d’IA sur ses propres données ?
Les classements publics comparent les modèles sur des épreuves générales. Ils ne disent pas lequel lira correctement vos bons de commande ou comprendra le vocabulaire de votre métier. La seule comparaison fiable se fait sur vos cas. Voici la méthode que nous suivons.
- Rassembler 30 à 50 cas réels, tirés de votre activité et anonymisés : des cas simples, des cas ambigus et quelques cas franchement difficiles. Un jeu de test sans cas difficile ne départage personne.
- Écrire la réponse attendue pour chaque cas, avec la personne qui fait ce travail aujourd’hui. C’est elle qui sait ce qu’est une bonne réponse.
- Fixer le seuil d’acceptation avant le test : par exemple, aucune erreur tolérée sur un montant, une marge acceptée sur la formulation d’un résumé.
- Passer les mêmes cas, avec la même consigne, à deux ou trois modèles de gammes différentes : un léger, un équilibré, éventuellement un modèle ouvert.
- Mesurer quatre choses : le taux de réussite, le respect du format de sortie, le coût par traitement et le temps de réponse.
- Lire les erreurs une par une. Une moyenne masque l’essentiel : un modèle qui se trompe rarement mais sur les montants est plus dangereux qu’un modèle qui hésite souvent sur la mise en forme.
- Retenir le modèle le moins coûteux parmi ceux qui passent le seuil, pas celui qui obtient la meilleure note.
- Conserver le jeu de test. Il resservira à chaque nouvelle version, à chaque changement de tarif et à chaque évolution de la consigne.
Ce travail prend quelques jours, pas quelques mois. C’est aussi ce que nous faisons pour un agent IA devis, où deux ou trois modèles sont comparés sur de vraies demandes clients avant tout développement.
Exemple type : trois modèles pour un agent d’analyse de contrats
Prenons un exemple type, qui ne décrit aucun client en particulier. Le service achats d’une PME industrielle reçoit chaque semaine des contrats fournisseurs, des avenants, des conditions générales et des courriers divers. L’acheteur veut retrouver vite la durée d’engagement, le préavis, la reconduction tacite et les pénalités, et être alerté quand une clause s’écarte de la politique achats de l’entreprise.
Passons la grille des cinq critères. Les données sont sensibles : prix négociés, conditions commerciales, noms de fournisseurs. Le critère des données écarte donc d’emblée tout traitement hors d’Europe et toute réutilisation des documents. La vitesse compte peu, personne n’attend la réponse à la seconde. Les capacités comptent beaucoup : une partie des contrats arrive en PDF scanné, parfois long.
Le travail se découpe en trois tâches, et chacune reçoit son modèle.
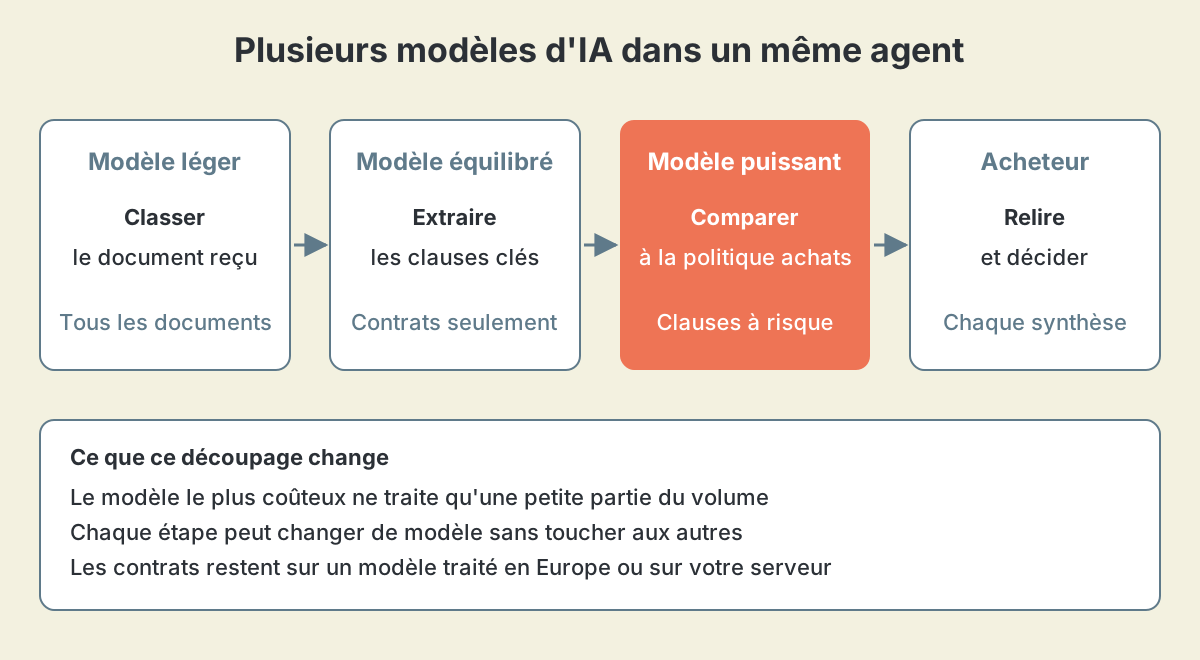 Dans cet exemple type, le modèle de pointe n’intervient que sur les clauses à risque. Tout le reste du volume passe par des modèles plus légers.
| Tâche | Volume | Modèle retenu | Pourquoi |
|---|---|---|---|
| Classer le document reçu (contrat, avenant, courrier, autre) | Tous les documents | Léger | Tâche simple, répétitive, facile à contrôler |
| Extraire les clauses clés dans un format structuré | Les contrats et avenants | Équilibré, capable de lire les scans | Demande de la précision, mais pas de raisonnement long |
| Comparer les clauses à la politique achats et expliquer les écarts | Les seules clauses qui sortent de la norme | Puissant | Raisonnement délicat, sur un petit nombre de cas |
Le test sur une quarantaine d’anciens contrats sert à vérifier cette répartition. Si le modèle léger confond avenants et contrats, on monte d’un cran sur cette seule étape. Si le modèle équilibré suffit à expliquer les écarts, on se passe du modèle de pointe. Dans tous les cas, l’agent ne signe rien et ne répond à aucun fournisseur : il prépare une synthèse que l’acheteur relit.
Peut-on utiliser plusieurs modèles dans un même agent ?
Oui, et c’est le cas des agents les plus efficaces. Rien n’oblige à choisir un seul modèle pour tout un agent : un modèle léger et bon marché s’occupe du tri, de la classification et des tâches simples, qui représentent l’essentiel du volume, et un modèle plus puissant n’est appelé que pour les cas qui le justifient. Cette répartition passe inaperçue dans une démonstration, mais elle fait la différence sur la facture une fois l’agent en production. Concevoir un agent, ce n’est donc pas parier sur le bon modèle : c’est placer les bons modèles aux bons endroits, et documenter ce découpage pour qu’il reste ajustable quand les prix ou les performances du marché évoluent.
Quand faut-il auto-héberger un modèle open source ?
L’auto-hébergement se justifie dans deux situations. Quand la confidentialité est critique, parce que les données ne quittent jamais votre infrastructure. Et quand le volume est élevé et régulier, parce que le coût devient fixe et prévisible au lieu de suivre chaque appel.
Il a un prix qu’il faut regarder en face : un serveur équipé de cartes graphiques, quelqu’un pour l’installer et le surveiller, des mises à jour à suivre, et des modèles généralement moins puissants que les meilleurs modèles propriétaires. Pour la plupart des PME, ce n’est pas la première marche. La voie intermédiaire, un modèle ouvert servi par un hébergeur européen, apporte déjà l’essentiel : un traitement en Europe, sans serveur à exploiter.
Sur le plan juridique, ce qui compte n’est pas l’étiquette open source ou propriétaire, mais le lieu de traitement, le contrat de sous-traitance et la non-réutilisation de vos données. Nous détaillons ces points dans notre article IA et RGPD : souveraineté des données. C’est la même logique qui guide notre agence n8n à Paris : l’orchestration tourne sur un n8n auto-hébergé en France, et les données restent dans ce périmètre.
Comment garder la liberté de changer de modèle ?
Les modèles évoluent vite, et ils ont une date de fin : les éditeurs publient un calendrier de retrait de leurs anciennes versions. Un agent soudé à un modèle unique devra donc être repris un jour, que vous le vouliez ou non. Autant le prévoir dès la conception.
Quatre habitudes suffisent :
- Isoler l’appel au modèle dans une brique unique de l’agent, pour que changer de fournisseur ne touche pas au reste.
- Garder les consignes hors du code, versionnées et documentées, parce qu’une consigne se réajuste à chaque changement de modèle.
- Conserver le jeu de test, qui dit en une heure si le nouveau modèle fait aussi bien que l’ancien.
- Ouvrir le compte d’API à votre nom, pour que le contrat et les données d’usage vous appartiennent.
Cette souplesse est le pendant technique de la réversibilité, qui vous évite d’être enfermé chez un prestataire ou chez un éditeur.
Le modèle fait-il la fiabilité d’un agent ?
Pas à lui seul. Réduire un agent à la question « quel modèle utilises-tu ? » est une erreur fréquente : le modèle n’est qu’une brique, et probablement pas la plus déterminante.
Ce qui fait la fiabilité d’un agent, c’est l’architecture autour du modèle. La qualité des connexions à vos outils, que nous détaillons sur notre page intégrations. Les règles métier qui encadrent ses décisions, appliquées par du code et non par le modèle. Et la supervision humaine, qui contrôle ses actions sensibles. Un modèle moyen, bien encadré et bien supervisé, fait mieux qu’un modèle de pointe lâché sans garde-fous.
Checklist : avant de valider le choix d’un modèle
- La tâche est décrite en une phrase, avec un exemple de bonne réponse.
- La sensibilité des données est tranchée : ce qui peut sortir, ce qui doit rester en Europe, ce qui ne doit pas quitter votre serveur.
- Un jeu de 30 à 50 cas réels existe, avec les réponses attendues.
- Deux ou trois modèles ont été testés avec la même consigne.
- Le coût par traitement est mesuré et multiplié par le volume mensuel prévu.
- La licence du modèle ouvert, s’il y en a un, a été lue.
- Le modèle est remplaçable : appel isolé, consignes documentées, compte d’API à votre nom.
- La date de retrait annoncée par l’éditeur est notée, avec une revue prévue avant cette échéance.
Questions fréquentes
Quel est le meilleur modèle d’IA en 2026 ?
Il n’y en a pas un seul. Les modèles de pointe d’Anthropic, d’OpenAI et de Google se dépassent à tour de rôle, et l’ordre change selon la tâche mesurée. Pour un agent en entreprise, le meilleur modèle est le moins coûteux de ceux qui réussissent votre jeu de test en respectant vos contraintes sur les données.
ChatGPT, Claude, Gemini ou Mistral : lequel choisir pour une entreprise ?
Les quatre éditeurs proposent des gammes comparables, du modèle léger au modèle de pointe. La différence se fait sur vos cas réels, sur les conditions de traitement des données et sur le prix à votre volume. Si le traitement en Europe ou l’auto-hébergement est une exigence, les modèles de Mistral AI et les modèles à poids ouverts partent avec un avantage.
Un modèle d’IA open source est-il gratuit ?
Le modèle se télécharge sans payer de licence, mais le faire tourner n’est pas gratuit : il faut un serveur avec carte graphique, ou un hébergeur qui facture à l’usage, et du temps pour l’exploiter. La licence peut aussi encadrer l’usage commercial. Le calcul se fait donc sur le coût complet, pas sur le prix du téléchargement.
Faut-il changer de modèle à chaque nouvelle version ?
Non. Une nouvelle version se teste sur votre jeu de cas avant toute bascule : elle peut être meilleure en général et moins bonne sur votre tâche. On change quand le test montre un gain réel de qualité ou de coût, ou quand l’éditeur annonce le retrait de la version utilisée.
Choisir une méthode plutôt qu’un nom
Le modèle qui domine aujourd’hui ne sera peut-être pas le bon choix dans un an. Ce qui dure, c’est la démarche : cinq critères, un jeu de test tiré de votre activité, plusieurs modèles placés aux bons endroits et un agent conçu pour en changer. Le choix du modèle se fait dès le cadrage, comme le décrit notre méthode de projet d’agent IA. Une question sur le modèle adapté à votre cas ? Échangeons : nous vous dirons ce qui se justifie, et ce qui serait surdimensionné pour rien.