La gestion des erreurs dans Make est ce qui sépare un scénario qui marche le jour de la démonstration d’un scénario qui tient pendant des mois. Sans réglage, Make arrête l’exécution au premier module en échec, annule ce qu’il peut, et finit par désactiver le scénario après quelques échecs de suite. Avec les bons gestionnaires d’erreurs, le stockage des exécutions incomplètes et une alerte bien routée, la plupart des pannes se règlent seules et les autres arrivent chez quelqu’un qui peut agir. Voici comment Make traite une erreur, ce que fait chacun des cinq gestionnaires, et la configuration que nous posons sur chaque scénario que nous livrons.
Que fait Make quand un module tombe en erreur ?
Par défaut, pas grand chose de bon pour vous. Si aucun gestionnaire n’est attaché au module et que le stockage des exécutions incomplètes est désactivé, Make applique un Rollback : l’exécution s’arrête, les modules qui le permettent annulent leurs écritures, et l’exécution est marquée en erreur (vue d’ensemble de la gestion des erreurs, centre d’aide Make).
Chaque échec compte ensuite dans le réglage « Number of consecutive errors » du scénario, à 3 par défaut. Une fois ce seuil atteint, Make désactive le scénario (réglages du scénario). Certaines erreurs, comme le dépassement de la limite d’opérations ou de taille de données, coupent même la planification immédiatement.
Concrètement, une API de facturation indisponible dix minutes un lundi matin peut suffire à arrêter un scénario de synchronisation pour toute la semaine, si personne ne lit l’email de désactivation. C’est le cas le plus fréquent que nous rencontrons quand nous reprenons un compte, comme nous le racontions dans notre article sur les signaux qui justifient un expert Make.
Quels sont les types d’erreurs dans Make ?
Avant de choisir un gestionnaire, il faut savoir à quoi on a affaire. Make classe les erreurs par type, et ce type change la bonne réponse.
| Type d’erreur | Ce qu’elle signifie | Réponse adaptée |
|---|---|---|
| ConnectionError | Le service distant ne répond pas ou coupe la connexion | Réessayer plus tard |
| RateLimitError | Trop d’appels en peu de temps pour l’API | Réessayer plus tard, en espaçant |
| ModuleTimeoutError | Le module a mis trop de temps à répondre | Réessayer, puis alléger le traitement |
| DataError | Donnée invalide ou mal mappée (date, format, champ obligatoire vide) | Corriger le mapping ou filtrer en amont |
| RuntimeError | Erreur renvoyée par le service lui-même | Lire le message, traiter au cas par cas |
| AccountValidationError | Identifiants de connexion refusés, expirés ou révoqués | Reconnecter, idéalement sur un compte de service |
La distinction utile est simple : les erreurs temporaires (connexion, limite de débit, délai dépassé) se règlent en réessayant, les erreurs de données ou d’accès ne se règlent jamais toutes seules. Réessayer dix fois une facture dont la date est mal formatée ne sert qu’à consommer des crédits.
Retry, Skip, Resume, Commit, Rollback : quel gestionnaire choisir ?
Make propose cinq gestionnaires d’erreurs, que l’on attache à un module par un clic droit puis « Add error handler ». Deux ont changé de nom en 2026 : Break s’appelle désormais Retry et Ignore s’appelle Skip, sans changement de comportement. Les anciens tutoriels et les blueprints exportés gardent les anciens noms (annonce sur la communauté Make, page Retry du centre d’aide).
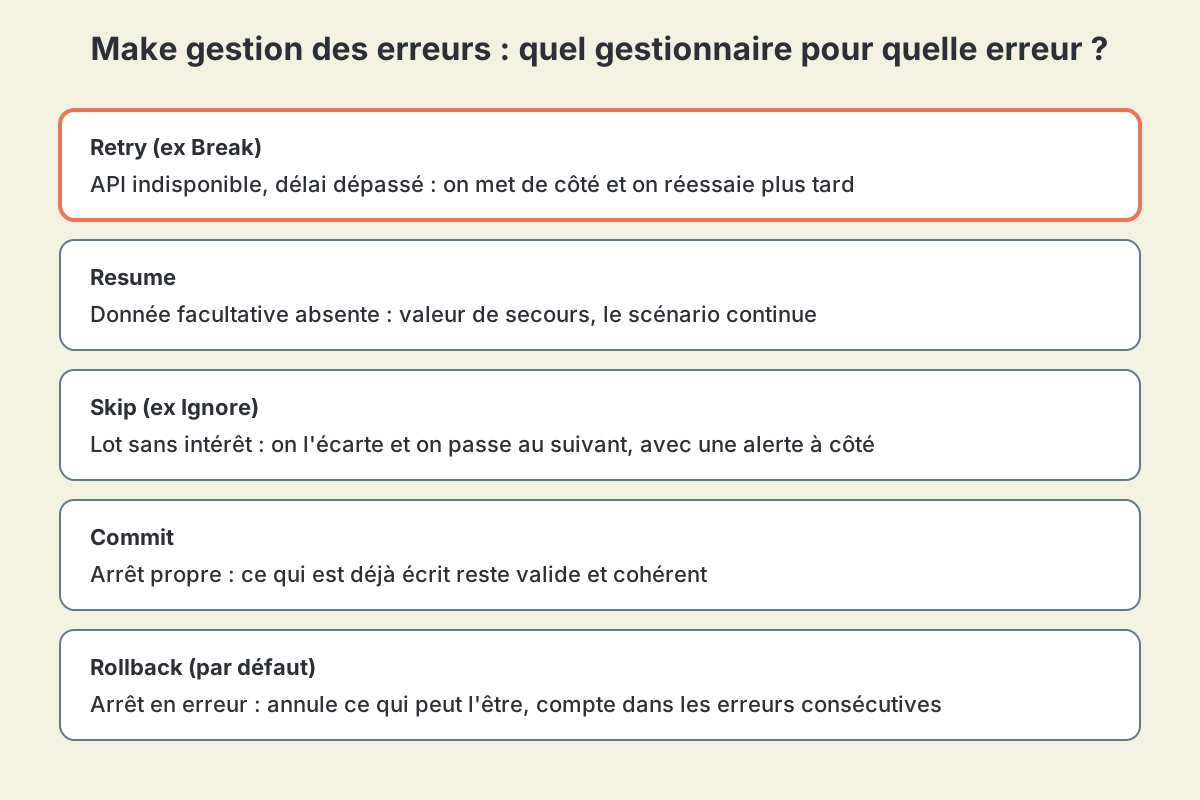 Les cinq gestionnaires d’erreurs de Make et l’usage que nous en faisons. Retry (en orange) est celui que nous posons le plus souvent.
Retry : pour les erreurs temporaires
Retry met de côté le lot en échec sous forme d’exécution incomplète, puis le reprend. Avec la reprise automatique activée, les réglages par défaut prévoient jusqu’à 3 tentatives espacées de 15 minutes. C’est notre choix par défaut devant tout appel à une API externe : CRM, outil de facturation, banque, modèle d’IA.
Condition indispensable : activer « Allow storing of incomplete executions » dans les réglages du scénario. Sans ce réglage, Retry ne peut rien stocker.
Resume : pour une donnée facultative
Resume remplace la sortie du module en échec par une valeur que vous définissez, et le scénario continue. Nous l’utilisons quand l’information manquante n’est pas bloquante : un enrichissement d’entreprise qui ne trouve pas le SIREN, une recherche de contact qui ne renvoie rien. Le reste du traitement se fait avec une valeur vide ou par défaut, clairement identifiable.
Skip : à manier avec prudence
Skip abandonne le lot en erreur et passe au suivant ; l’exécution se termine en succès. C’est pratique dans une boucle sur 200 lignes où une ligne malformée ne doit pas bloquer les 199 autres. C’est aussi le meilleur moyen de perdre des données sans le savoir. Nous ne posons jamais Skip sans un module d’alerte juste avant, sur la même route.
Commit et Rollback : arrêter proprement
Commit arrête l’exécution en validant ce qui a déjà été fait, et la marque en succès. Rollback arrête et annule ce qui peut l’être (seuls certains modules, ceux qui gèrent les transactions, savent vraiment annuler). Nous réservons Commit aux cas où une exécution partielle reste cohérente, et nous remplaçons le Rollback implicite par un choix explicite partout où il compte.
Comment fonctionnent les exécutions incomplètes ?
C’est le réglage le plus sous-estimé de Make. Une fois activé, quand un module échoue, Make enregistre l’état de l’exécution à cet endroit : les données déjà traitées, le module en cause, le message d’erreur. Vous la retrouvez dans l’onglet « Incomplete executions » du scénario, vous pouvez corriger le mapping puis la relancer là où elle s’était arrêtée, sans rejouer les modules précédents.
Trois détails comptent en production :
- Reprise automatique des erreurs temporaires. Avec ce stockage activé, Make reprend de lui-même les erreurs de connexion et de limite de débit, selon un calendrier qui commence à une minute et s’espace jusqu’à trois heures, sur huit tentatives (gestion des exécutions incomplètes). Pas besoin de Retry pour ces cas, mais Retry vous laisse régler le nombre et l’intervalle.
- Le premier module est une exception. Si l’erreur survient sur le déclencheur, il n’y a en général rien à stocker : il faut alors surveiller le déclencheur autrement.
- La durée de conservation. Sur la formule gratuite, les exécutions incomplètes expirent au bout de 30 jours. Le stockage a aussi une limite : un compte qui accumule des milliers d’exécutions incomplètes jamais traitées finit par ne plus rien stocker.
Comment être prévenu quand un scénario Make échoue ?
L’email automatique de Make part vers le propriétaire de l’organisation ou du scénario, souvent la personne qui a créé le compte. C’est insuffisant. Une route de gestion d’erreur peut contenir des modules ordinaires avant le gestionnaire final : c’est là que nous plaçons l’alerte.
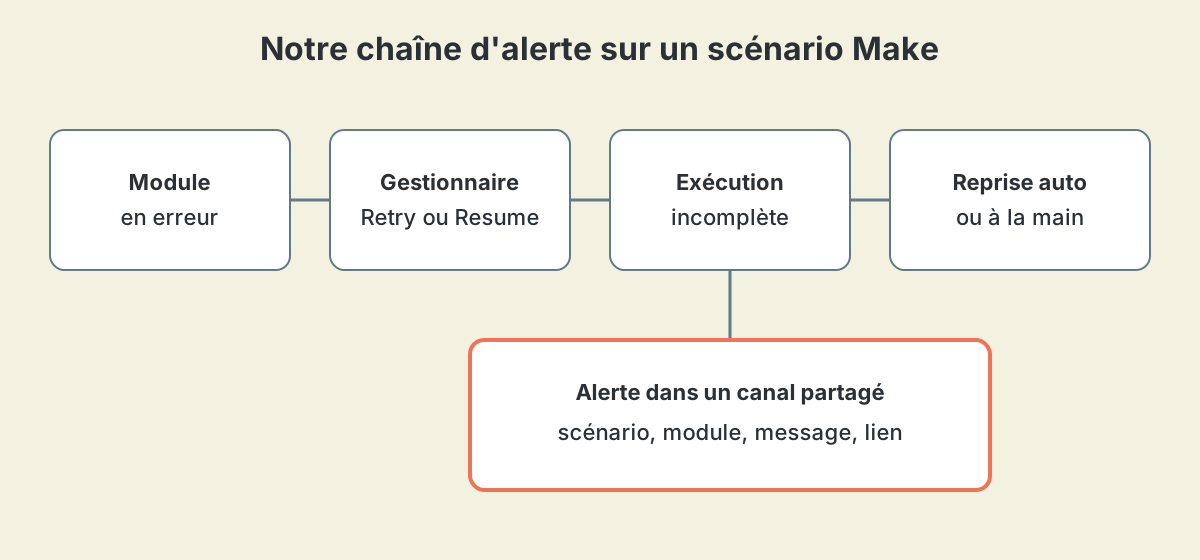 La chaîne que nous posons sur les modules critiques : l’erreur est reprise si elle peut l’être, et signalée dans tous les cas.
Notre route type, sur chaque module qui appelle un service externe :
- Un module Slack, Teams ou email vers une adresse partagée (jamais une boîte personnelle), avec le nom du scénario, le module, le message d’erreur (
{{error.message}}) et le lien vers l’exécution. - Le gestionnaire adapté : Retry pour un appel d’API, Resume pour un enrichissement, Skip seulement dans une boucle.
- Un nombre d’erreurs consécutives relevé sur les scénarios dont la source est instable, pour éviter une désactivation sur une panne passagère, et laissé bas sur les scénarios qui écrivent dans la compta, où mieux vaut s’arrêter que d’insister.
Le principe est le même que pour les agents IA : une automatisation fiable est une automatisation dont on voit les échecs. Nous l’avons développé dans notre article sur la supervision humaine des agents.
Comment éviter les erreurs avant qu’elles arrivent ?
Le meilleur gestionnaire est celui qui ne se déclenche pas. Quatre habitudes réduisent fortement les DataError :
- Filtrer tôt. Un filtre juste après le déclencheur écarte les enregistrements incomplets (email vide, montant nul) avant qu’ils n’atteignent un module qui les refusera.
- Prévoir les valeurs vides dans le mapping. La fonction
ifempty()fournit une valeur de secours ;formatDate()etparseDate()évitent les dates mal interprétées entre deux outils. - Espacer les appels. Pour une API à quota strict, un module Sleep ou le traitement séquentiel du scénario évite une série de RateLimitError.
- Utiliser des comptes de service. Une connexion au nom d’un salarié qui change son mot de passe produit une erreur d’accès que rien ne rattrape.
L’actualité récente va dans le même sens. À l’automne 2026, Make a ajouté aux Make AI Agents une connexion de secours : si le fournisseur de modèle principal ne répond pas, l’agent bascule sur une autre connexion, Make AI Provider par défaut ou un modèle de votre choix, réglée dans les paramètres avancés du module (présentation sur la communauté Make). Pour un scénario qui appelle un modèle d’IA, c’est désormais le premier réglage de fiabilité à poser, avant même Retry.
Ce que nous livrons sur chaque scénario Make
Quand nous construisons ou reprenons un compte, chaque scénario en production sort avec la même base :
| Élément | Notre réglage |
|---|---|
| Exécutions incomplètes | Activées |
| Appels d’API externes | Retry, avec alerte sur la route |
| Données facultatives | Resume avec valeur par défaut identifiable |
| Boucles | Skip seulement avec alerte, jamais seul |
| Erreurs consécutives | Ajustées selon la criticité du scénario |
| Alertes | Canal ou adresse partagés, message avec lien vers l’exécution |
| Documentation | Une fiche par scénario : déclencheur, outils, erreurs prévues, personne à prévenir |
C’est une partie du travail que fait notre agence Make et Zapier lors d’un audit ou d’une reprise : nous ne reconstruisons pas les scénarios, nous les rendons fiables. La démarche complète, du cadrage à la mise en production, est décrite sur notre page méthode. Et quand un compte devient trop coûteux ou trop complexe pour Make, nous expliquons comment nous procédons dans migrer de Make vers n8n, où le workflow d’erreur centralisé joue le même rôle.
Questions fréquentes
Quelle différence entre Break et Retry dans Make ?
Aucune sur le fond : Make a renommé Break en Retry en 2026, et Ignore en Skip. Le comportement est identique, seuls les libellés ont changé. Les blueprints exportés et les anciens tutoriels utilisent encore les anciens noms.
Pourquoi mon scénario Make s’est-il désactivé tout seul ?
Le plus souvent parce qu’il a atteint le nombre d’erreurs consécutives autorisé (3 par défaut) sans gestionnaire pour les rattraper. Certaines erreurs, comme le dépassement de la limite d’opérations, désactivent aussi la planification immédiatement. Activez les exécutions incomplètes et posez un Retry sur les appels d’API pour éviter ces arrêts sur des pannes passagères.
Les reprises automatiques consomment-elles des crédits ?
Oui : chaque tentative exécute à nouveau les modules concernés. C’est une raison de plus pour ne pas réessayer les erreurs de données, qui échoueront à chaque fois, et de les corriger à la source.
Faut-il un gestionnaire d’erreur sur chaque module ?
Non. Nous en posons sur les modules qui parlent à un service externe ou qui écrivent une donnée importante. Un module de formatage interne ou un routeur n’en a généralement pas besoin.
Fiabiliser un compte Make demande surtout de la méthode : savoir quels scénarios comptent, quelles erreurs sont temporaires et qui doit être prévenu. Si vos scénarios s’arrêtent sans prévenir ou si personne n’ose plus y toucher, notre agence Make peut les reprendre, poser cette gestion des erreurs et vous laisser une documentation claire.